用 AI Native
探索 AI 如何融入日常工作

背景
搭建个人网站时,我并不是单纯从作品集的角度去考量,而是将它当作凝练AI能力的试验田。网站的最终产出仍然是作品集而非AI产品,但构建和维护它的过程,可以运用 AI Native的思维模式持续优化。
这里,我把 AI Native 分成两个评价轴:Product 关注最终用户获得什么体验,Workflow 关注生产者如何完成工作。前者问 AI 是否成为产品能力的一部分,后者问 AI 是否进入持续产出的过程。两者可以分别成立。
| 工作流 / 产品 | 非 AI-native Product | AI-native Product |
|---|---|---|
| 非 AI-native Workflow | 产品不依赖 AI 能力,生产也沿用常规流程 | 产品包含 AI 能力,但生产仍沿用常规流程 |
| AI-native Workflow | 产品不依赖 AI 能力,但生产流程包含 AI 的计划、执行与人工反馈。本项目探索这一格 | 产品体验与生产流程都将 AI 纳入其中 |
即使最终的产出物并非AI Native Product, 也需要关注从用户意图到AI执行的完整交互闭环,包括Agent Work Flow,AI Autonomy, Human-in-the-loop,结果验证与纠错等。通过无数次迭代去持续优化流程,最终保证这个流程能够熟练的运用在实际商业合作中。
全新的工作流程
在这次探索里,我负责目标、取舍、审美判断和最终批准。AI 在明确范围内读取依据、制定计划,进入内容区、设计区或开发区执行,再把可检查的结果交回来。它不必每次从头重做;修改可以从需要调整的工作区开始。
- 01共享依据
Figma 资产、任务范围、验收条件
图中检查点不是要求人审查每一步工具调用。重点是目标或权限改变、事实进入公开叙事、候选进入当前产品,以及发布这些节点。范围内的实现与检查可以连续进行;资料不足或出现冲突时暂停。内容区仍遵守 master 审批与来源同步,不直接根据临时对话生成事实。内容或 Figma 资产任务可以独立交回评审,只有需要组成网页或运行原型时才进入开发区。图 B 的虚线表示条件步骤或下轮读取,不表示自主后台运行。没有发布授权时,本地交付就是本轮终点。
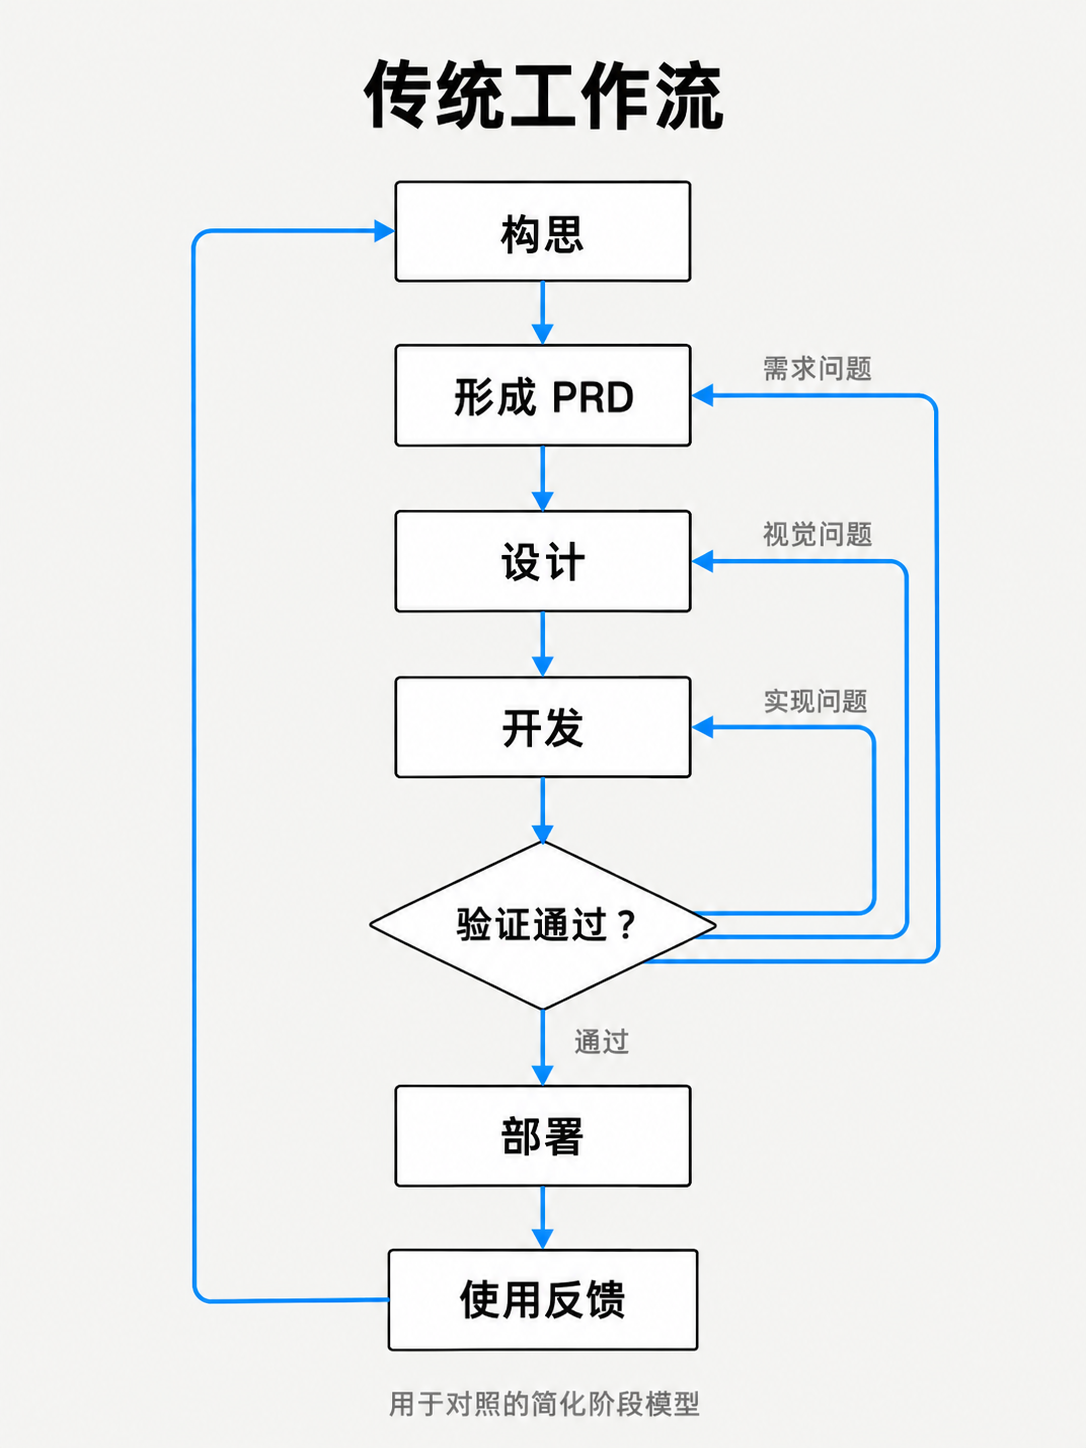
传统工作流程
AI-native 工作流程
工作环境与反馈循环
Harness Engineering的核心是给模型配置可持续工作的环境与约束。长期任务中的进度材料、增量工作与测试,是官方工程实践讨论的重点。 Anthropic:Effective harnesses for long-running agents 在本项目中有类似的配套实践:Obsidian进行工作环境搭建:CURRENT_SYSTEM 描述当前实现,Skill 与脚本提供方法和检查,任务记录与 Git 保存进度;AGENTS 与治理文档进行约束:限定权限和产品边界。
Loop Engineering在这里是有人参与的“执行 → 检查 → 评审 → 纠正”循环。AI 可以依据反馈继续执行,但采用决定和扩大范围仍由我确认。 Anthropic:Building effective agents
从用户意图到 AI 执行:八个需要回答的问题
- 01 / USER INTENT用户真正想完成什么?
- 把网站做得更合适,同时形成能持续复用的工作方法;不是只生成一版页面。
- 02 / CONTEXTAI 需要知道什么?
- 已批准的事实、当前实现、Figma 资产、任务范围,以及本轮不允许改变的内容。
- 03 / AGENCYAI 可以做到哪一步?
- 在范围内探索、实现和检查。扩大范围、采用候选与发布,由人决定。
- 04 / WORKFLOWAI 如何拆解任务?
- 按事实、视觉与实现拆到内容区、设计区、开发区;独立任务不必全部经过开发。
- 05 / INTERACTION人如何表达与干预?
- 用目标、参考、浏览器评论和可运行对照给反馈;必要时修改方向或停止任务。
- 06 / VERIFICATION如何判断结果正确?
- 核对来源、组件状态、响应式表现与运行结果;检查通过不能代替设计判断。
- 07 / RECOVERYAI 出错怎么办?
- 把问题送回所属工作区,保留历史版本和修改记录。依据不足或变更冲突时先暂停。
- 08 / MEMORY哪些上下文要保留?
- 保留批准事实、当前状态、采用决定、失败原因和来源;不把每次临时输出都升格成规则。
这种流程带来了什么变化?
快速 prototype,让判断离真实产品更近一步。设计系统探索中,我把多个方向放到同一浏览环境比较,也保留 V1 与 V2 的迭代对照。字体、留白、表面与交互可以在可运行页面里检查,帮助我判断什么适合当前网站。

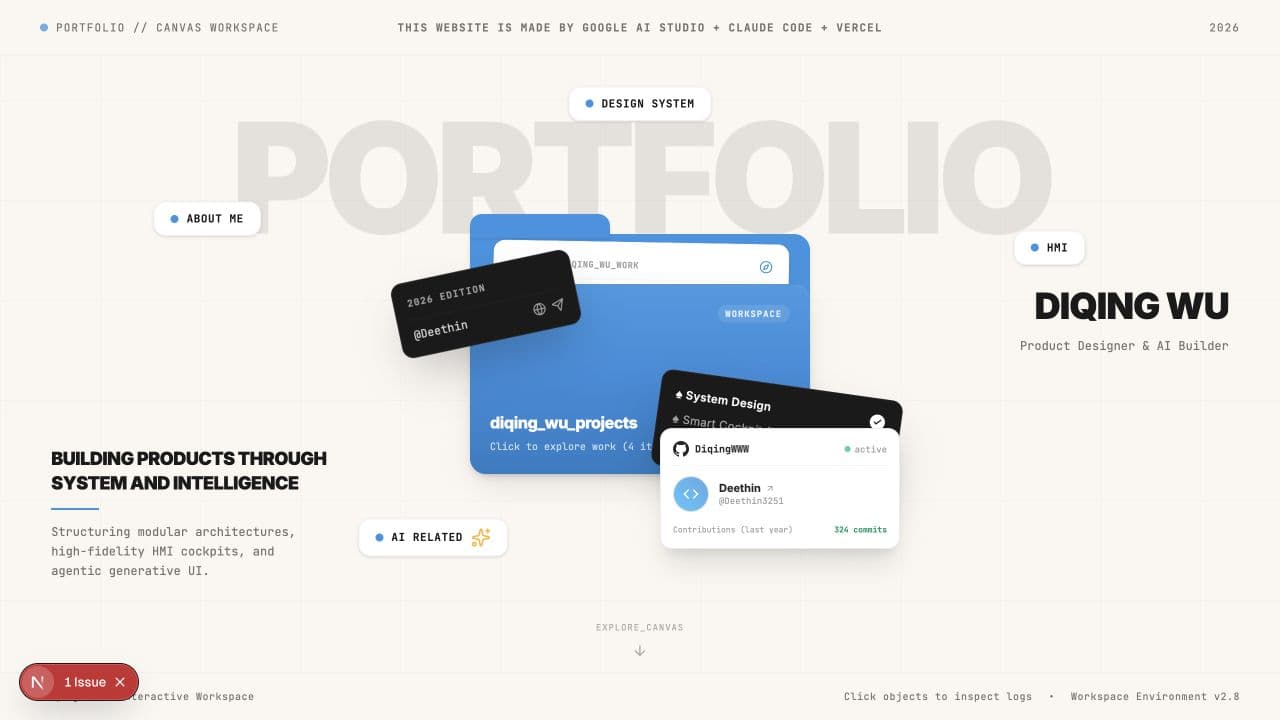
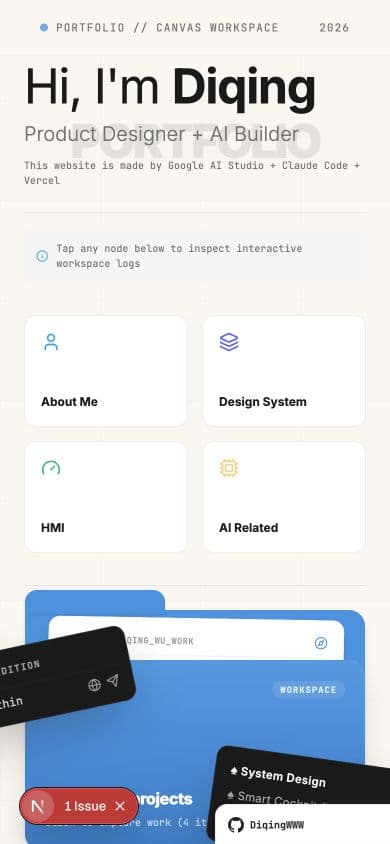
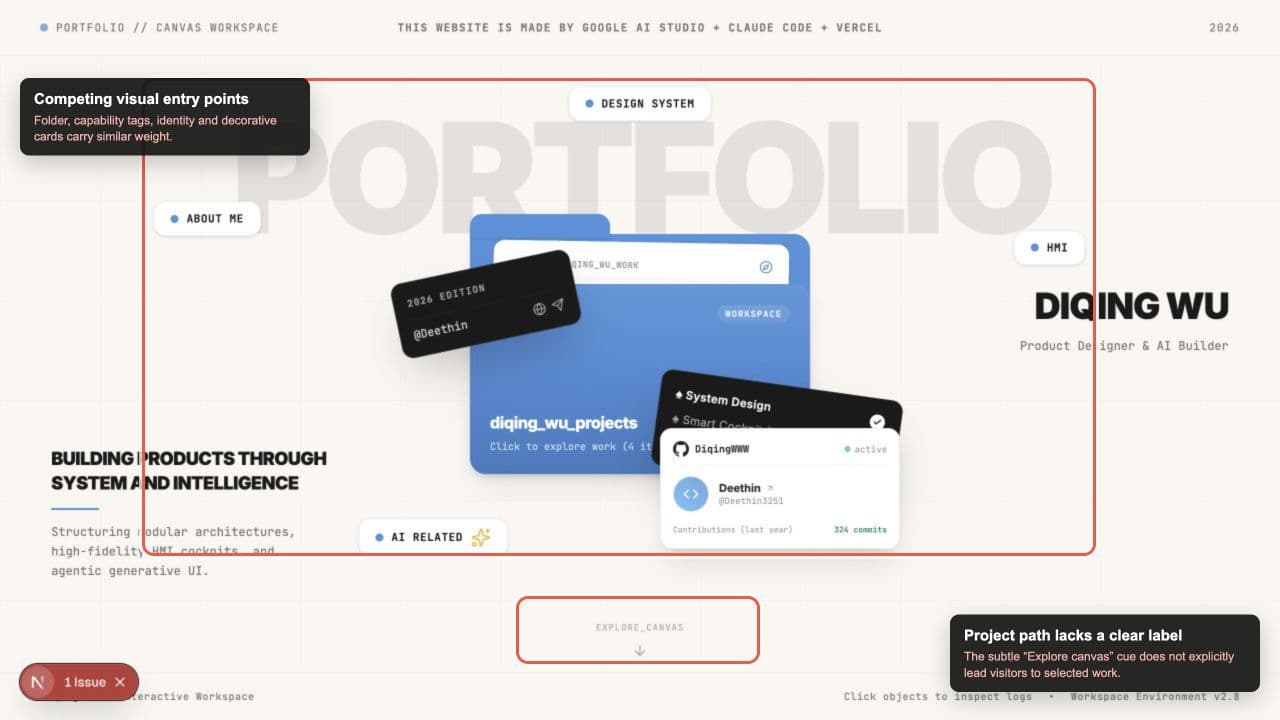
概念出现了,优先级没有出现
Folder、能力标签、身份卡片与 Canvas 隐喻同时争夺注意力;移动端只是把入口依次堆叠。
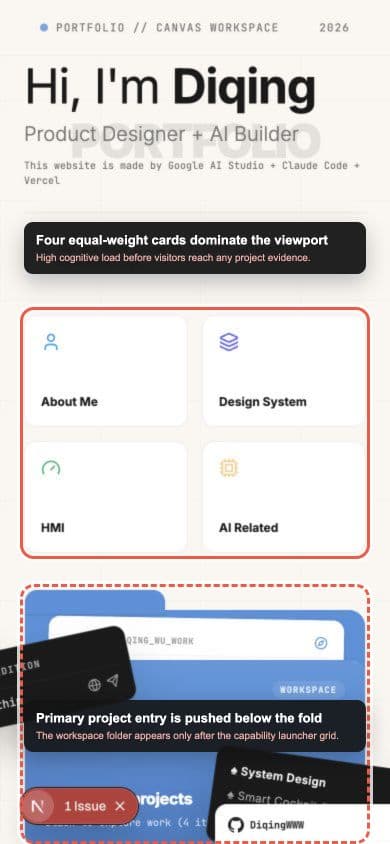
把“感觉不对”变成可定位问题
评审指出项目入口不明确、装饰与内容争夺层级,以及移动端在展示真实工作前就要求用户面对多个等权选择。
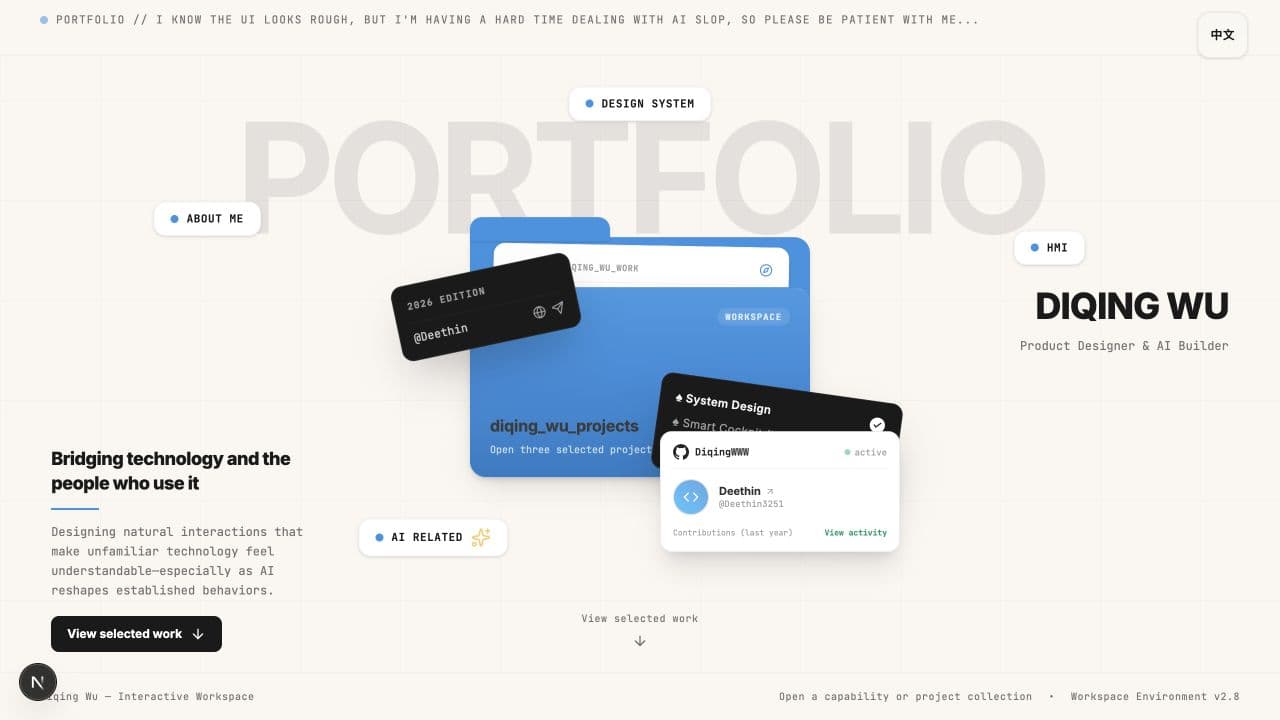
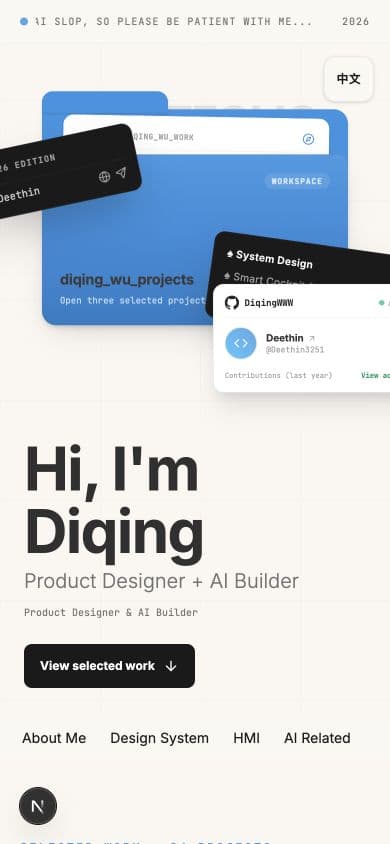
先展示项目,再提供分类入口
Folder 成为首屏主对象,Selected Work 获得明确入口,能力标签退到辅助层;移动端把项目提前,并将能力卡压缩为轻量导航。
设计因此不再只是开发之前的上游交付。我仍在前期定义方向,也在可运行产品形成之后做最后的“守门员”:判断哪些生成结果值得留下,哪些必须退回重做。
与只在对话里使用 AI 有什么区别?
这里的 AI Native,具体指什么?
这里的 AI Native 指一种工作安排:AI 可以读取项目资料、修改设计文件和代码,但先要知道哪些事实已确认、允许改哪里、结果由谁评审。资料和决定保存在项目里,换一个 Agent 也能继续查阅。
| 范围 | 普通 AI | AI Native | 本项目 |
|---|---|---|---|
| 工作产出 | 交付最终答案,过程信息大多留在对话里 | 保留生成的结果,也保留修改记录和评审决定,供下一次工作查看 | 事实在 master,视觉在 Figma,代码变化在 Git,评审结论在返回报告 |
| 项目记忆 | 新对话需要重新解释背景 | 新 Agent 开始前,先读已确认的资料、当前进度和允许改动的范围 | master 保存事实,治理文档规定边界,CURRENT_SYSTEM 说明当前实现,Git 保留变化 |
| Agent 协作 | 把同一段宽泛指令交给不同工具,或让一个模型包办全部工作 | 交接任务时写清用哪些资料、能改什么、怎样检查、要返回什么 | Codex 整理 Figma 任务;WorkBuddy 执行;我检查返回的结构和视觉 |
| 方法复用 | 每次重新组织 prompt,经验依赖个人记忆 | 重复的操作写成可再次调用的步骤或脚本,发现问题后修正它们 | Skill 保存评审与 Figwright 操作步骤,脚本检查内容来源 |
| 不确定性 | 生成结果容易直接进入当前产品 | 新方案先单独试验,评审后再决定是否进入正式网站;扩大修改范围要另行确认 | 候选网页用独立地址,Figma 用试验页面;检查差异后再决定采用或退回 |
| 质量延续 | 每次结果单独评审,好的判断难以进入下一次生成 | 把评审通过的颜色、排版和组合方式保存下来,下次生成时使用并检查 | 同时看 Design System 和实际页面,检查新结果有没有保住确认过的设计关系 |
Harness 环境如何搭建?
| 范围 | 作用 | 实际载体 |
|---|---|---|
| Memory | 让事实、规则、当前状态和历史证据跨会话读取 | Obsidian master、治理文档、CURRENT_SYSTEM、任务记录、Skill 与 Git 按信息寿命分工 |
| Governance | 让 Agent 知道什么可以改、什么必须保持、规则应该存在哪里 | AGENTS.md、Portfolio OS、专项协议、任务说明与审计按适用范围分层 |
| Skill | 把重复方法与可确定操作从一次性 prompt 中分离 | 评审 Skill、Figwright 操作 Skill、UI 验证方法及内容同步与来源检查脚本 |
| Content pipeline | 让事实、选稿、翻译和页面呈现保持可追溯 | Obsidian factual master → owner 确认 → selection 与素材 → 中英文 TS → 项目页面 → 本地评审 |
| Sandbox | 把低成本试验与正式产品修改分开 | 独立 route、Figma page / collection、授权范围、Git diff 与回退记录;已确认变化再以局部差异进入当前实现 |
| Projects / Tags | 保持产品实体与分类关系正确 | Project 保存工作本体、资产与案例;Tag 支持多维发现,不替代项目身份 |
治理:让规则留在正确的层级
这张表用于区分长期边界、本次任务与历史证据:Agent 接手时知道什么能改,审计记录也不会自动变成新规则。
| 范围 | 规则载体 | 作用 |
|---|---|---|
| 跨任务共同约定 | AGENTS.md | 所有 Agent 接手前都需要理解的工作边界 |
| 长期产品边界 | Portfolio OS | 保存产品方向、信息架构与不可隐式改变的决定 |
| 特定领域 | 专项协议 | 管理内容管线、Design System 等领域方法 |
| 可重复方法 | Skill / 脚本 | 保存操作步骤、检查方式与已知限制 |
| 本次任务 | 任务说明 / handover | 说明目标、权限、验收和返回材料 |
| 历史证据 | 审计 / 返回报告 | 记录发生过什么,不自动升级为新规则 |
最大的挑战:AI 成为基础设施
一个完全原生的设计流程,最大的挑战在于让AI成为基础设施,允许其在任何流程中切入。
要让 AI 在不同阶段接入工作,难点在于它接手时是否能读到正确依据,知道自己能改什么,并交回可以判断的结果。工具能完成操作,并不代表它理解了设计意图。
让设计系统同时对人和 AI 可读
我希望设计系统既展示效果,也解释效果背后的规则:为什么要这样排版,组件用于什么情境,交互怎样进入和退出,哪些 token 与资产应被复用。
设计意图给 AI 看,展示效果给人看。设计规则、交互语义、Design Token与MCP深度结合,让AI理解设计意图后自动生成。Design System V2 是定义规范、试做组合和讨论设计意图的视觉窗口。它把说明、状态样本和可运行演示放在一起。
第二次设计:好页面还不等于好系统
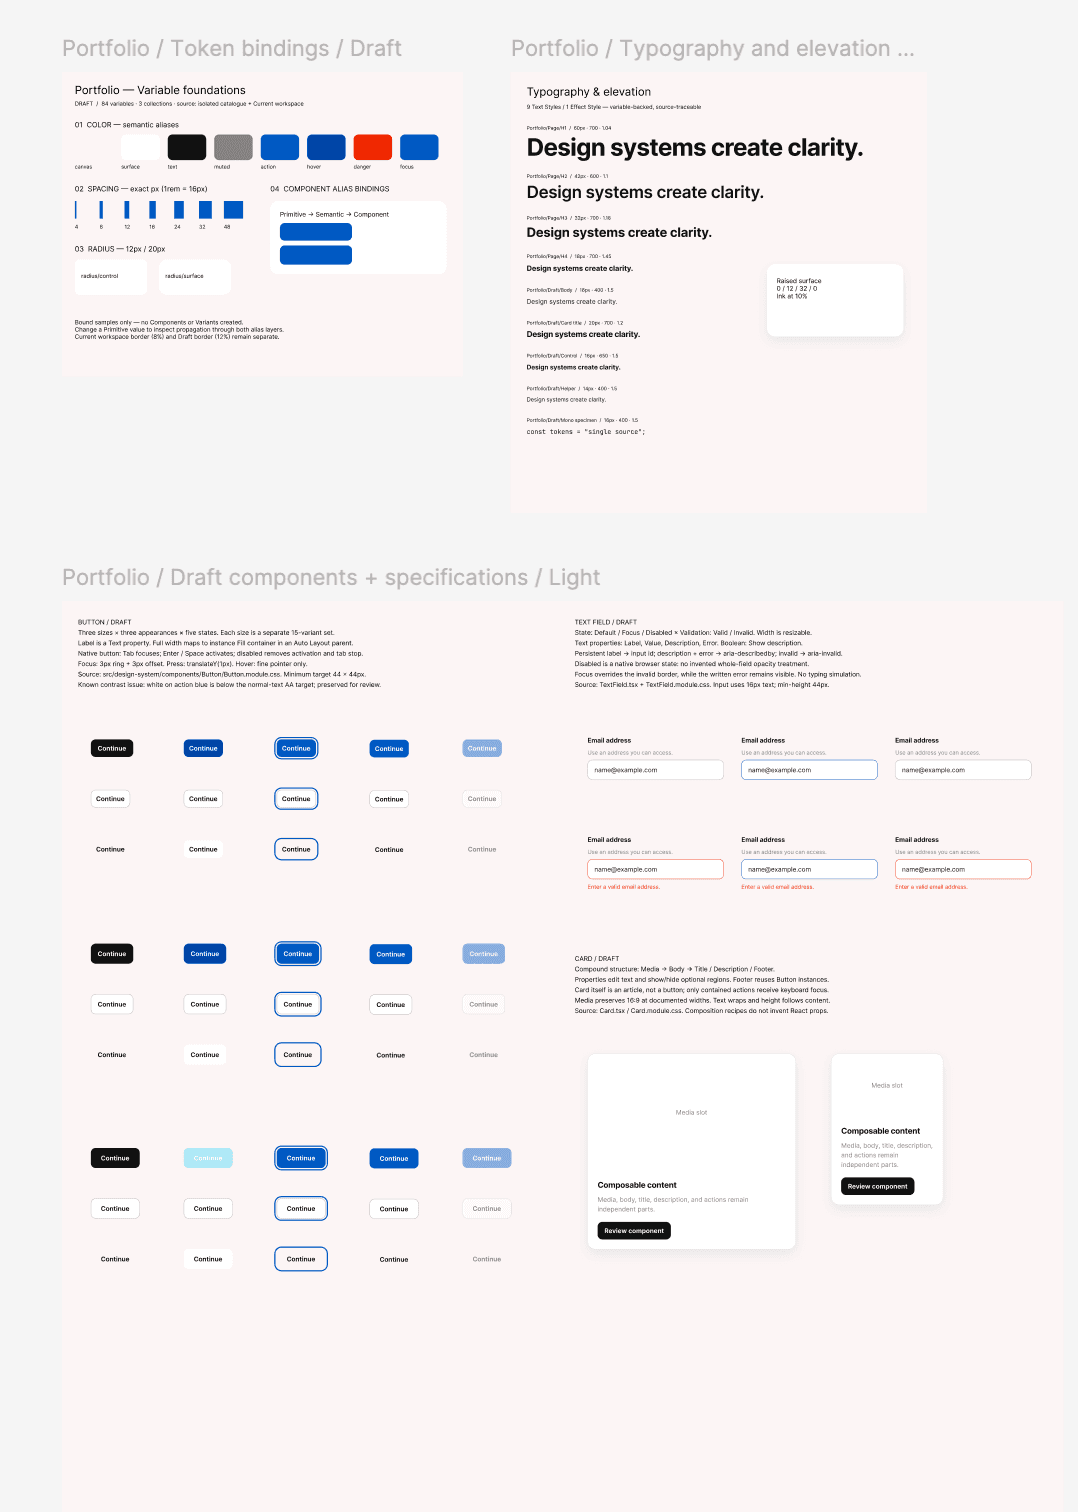
早期 Design System 已经有色卡、字号和组件,却没有保存页面中真正产生质量的关系。
颜色对了,页面却很生硬
Figma 草稿保留近似颜色和平铺区块,却丢失留白、图像比例、深浅节奏和阅读顺序。
完整度不能用 token 或组件数量代替,必须用真实内容组成代表页面进行判断。
名字对了,绑定关系却断裂
JSON 导入先出现非法变量名,随后 Semantic 层被导入为保存名称的 STRING,而不是引用原色的 COLOR。
检查必须进入真实数据类型与 alias,不能只看变量名称是否完整。
During / 尚未写清的交互规范
- 触发条件
- 进入
- 稳定状态
- 退出
- 触屏替代
- 减少动态效果
样式有了,却没有真正在交互
渐变、字号和 duration 无法说明触发、进入、稳定、退出、触屏替代与 reduced motion。
动效必须描述状态关系;静态 Hero fallback 不能被当成 WebGL 光场的完整复刻。
原色 → 语义 Paint Style → 手工 CSS 映射 → 真实页面验收
- Inuse-Primitive-colors保存真实 COLOR 原始值
原色保持数字命名,不承载 text、border 等用途语义
- 语义 Paint Styles表达文字、表面、操作与边框用途
Light / Inverse 表示使用环境,不假装成自动切换模式
- Inuse-dimensions保存已确认尺寸与间距
Figma 使用整数方案;不逐一照抄所有 CSS 流式值
- Text / Effect / Grid Styles组合字体、阴影与列网格
有复用理由才变量化;文字颜色单独使用语义 Paint Style
- 代表页面与组件状态检查资产能否共同工作
不能只检查变量表而不看真实内容
不建立重复的 Semantic Color 变量层;Light / Inverse 是使用环境,不是自动切换模式。

Design System V2
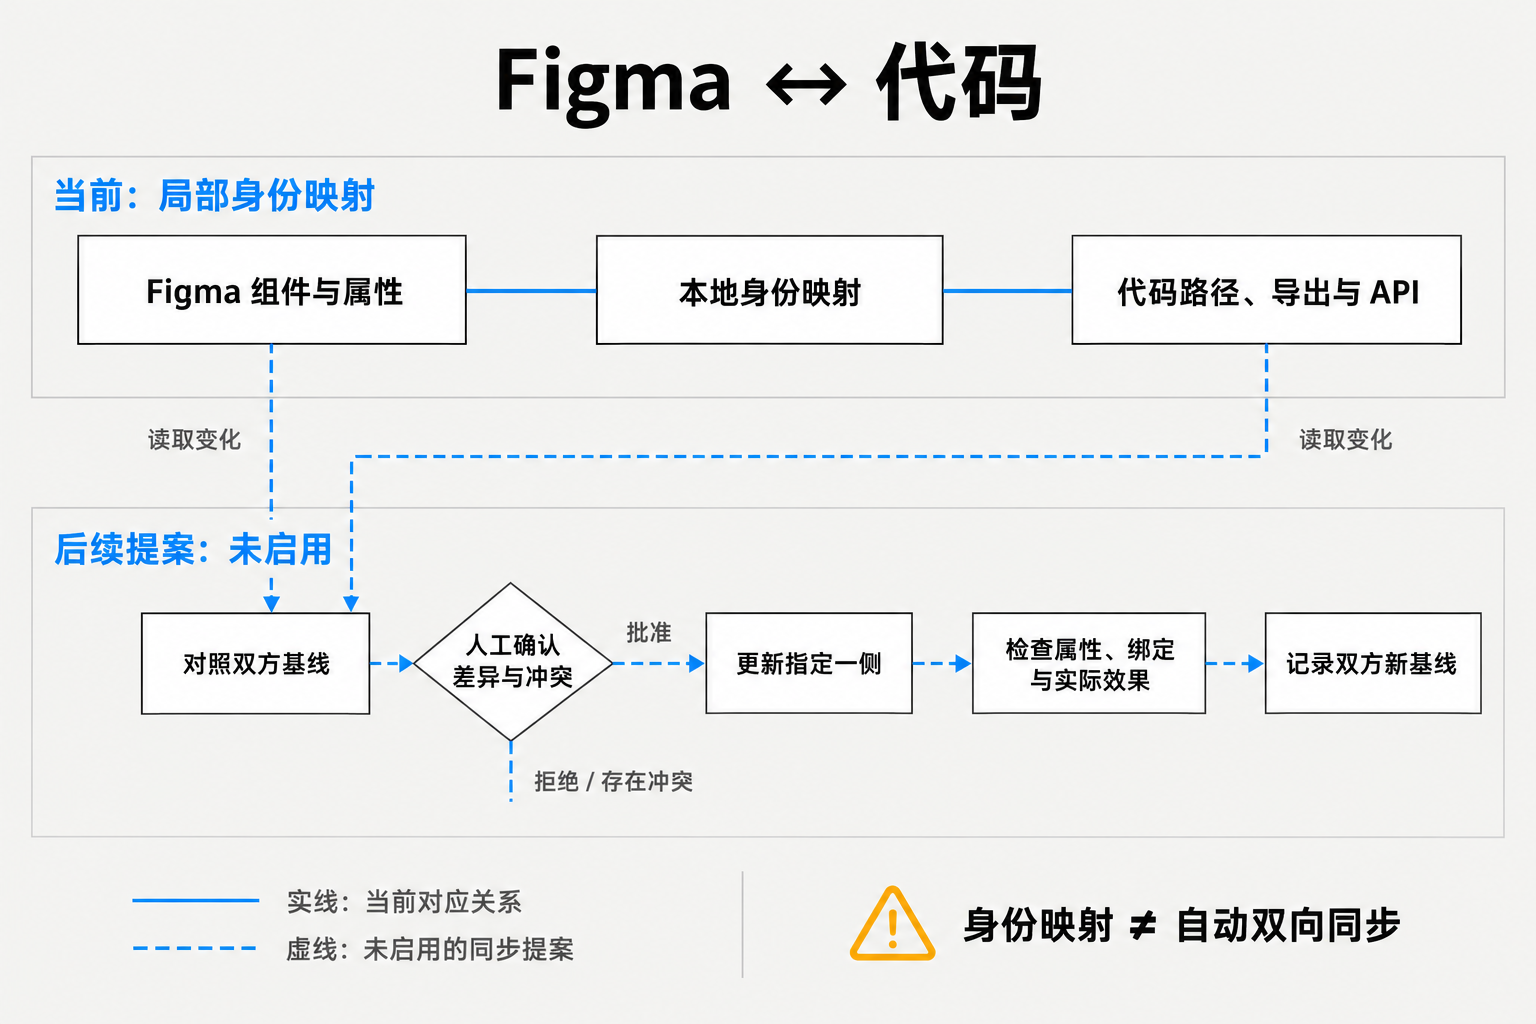
当前本地规范把 token、组件状态与组合样例放在一起审阅。Figma 到 CSS 仍是手工映射。
查看 Design System V2Figma ↔ 代码的双向映射
对照 Figma 的组件库与代码出口,记录身份、属性和差异,再进行双向查找。当前六条本地映射覆盖四个代码目标;其中三组 Draft Button 尺寸共用一个 Button。
Figma ↔ 代码的双向映射允许设计师可以在figma针对性的进行优化并同步至代码端,代码端输出完整内容后又可以将验证后的内容更新至figma。
下一步
用一个真实组件补齐 Figma 与代码的属性、token 和状态对照,先验证局部一致性。
在重复任务中观察下一轮是否正确复用已确认规则,保留成功与失败记录。
试做“检测差异 → 人工确认 → 更新一侧 → 验证”的单组件同步实验,再判断是否扩大范围。